같은 글을 두 번 올리지 않는 법 — 발행 장부를 만든 기록
앞 글까지는 글과 이미지를 만드는 쪽 얘기였다. 이번엔 시리즈를 이어서 다 만든 글을 올리는 순간에 생기는 문제를 적는다.
사람이 손으로 올릴 때는 이게 문제가 안 된다. 올렸는지 안 올렸는지 본인이 안다. 그런데 자동으로 여러 편을 올리기 시작하면 그 기억을 프로그램이 대신 가져야 한다. 기억을 못 하면 같은 글이 두 번 올라간다. 애드센스 심사를 기다리는 사이트에서 같은 글이 두 개 걸려 있으면 좋을 게 하나도 없다.
그래서 발행 장부를 만들었다. 어떤 글을 어느 사이트에 올렸는지 적어두는 작은 데이터베이스다.
발행 도중에 죽으면
처음 떠올린 건 단순한 구조였다. 발행이 성공하면 장부에 한 줄 적는다.
그런데 이러면 구멍이 하나 생긴다. 발행 요청은 성공했는데 장부에 적기 직전에 프로그램이 죽는 경우다. 글은 사이트에 올라가 있는데 장부에는 흔적이 없다. 다음에 다시 돌리면 장부만 보고 안 올린 글로 판단해서 또 올린다.
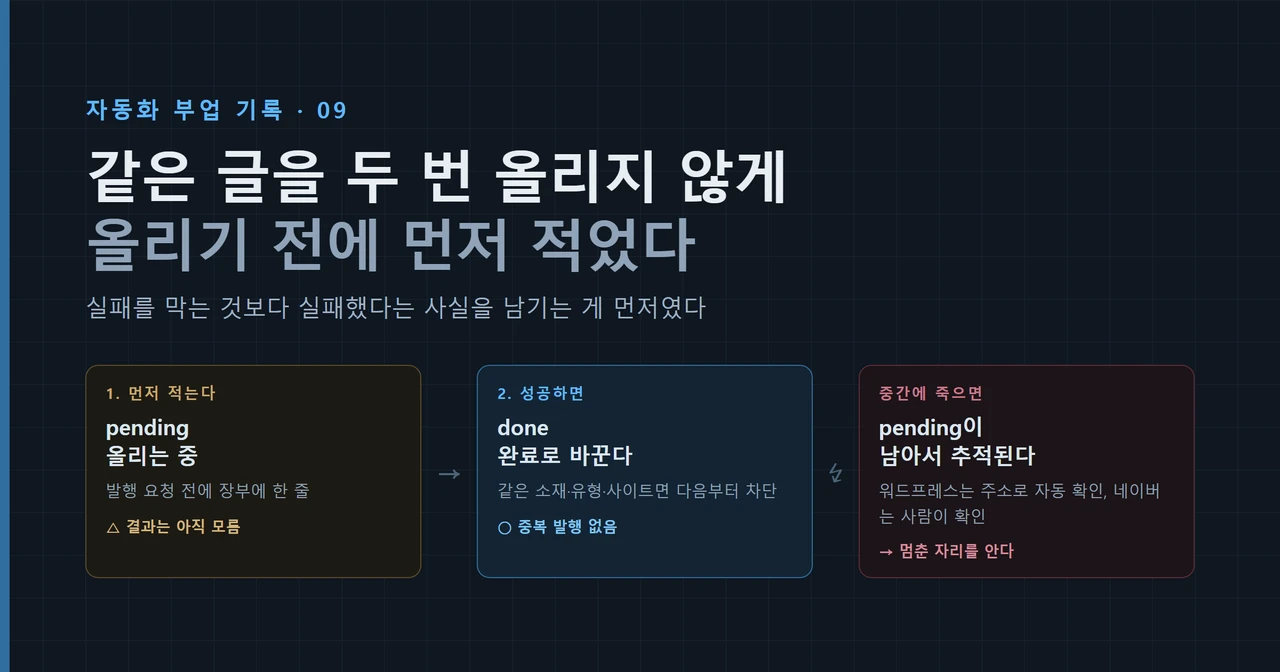
그래서 순서를 뒤집었다. 올리기 전에 먼저 “올리는 중”을 적고, 성공하면 “완료”로 바꾼다. 실패하면 실패로 적는다.
ledger.mark(source, angle, site, "pending")
try:
    post = publish(content)
except Exception:
    ledger.mark(source, angle, site, "failed")
    raise
ledger.mark(source, angle, site, "done")
이렇게 하면 중간에 죽어도 올리는 중이라는 기록이 남는다. 올라갔는지는 몰라도 뭔가 하다가 멈췄다는 사실은 안다. 모르는 상태를 없앨 수는 없어도 모른다는 걸 기록할 수는 있었다.
확인할 수 있는 곳과 없는 곳
올리는 중 기록이 남아 있으면 그게 실제로 올라갔는지 확인해야 한다. 여기서 플랫폼 차이가 났다.
워드프레스는 쉬웠다. 글마다 주소를 미리 정해서 올리니까, 그 주소로 글이 있는지 물어보면 된다. 있으면 완료로 고치고, 없으면 기록을 지운다. 사람이 끼어들 필요가 없다.
네이버 블로그는 그게 안 됐다. 5편에서 적었듯이 공식 API가 없어서 브라우저로 올린다. 밖에서 이 글이 올라갔는지 물어볼 통로가 없다. 그래서 자동 복구를 포기했다. 올리는 중 기록이 남은 채로 다시 발행하려 하면 AI에게 확인하라는 알림을 주고, AI가 사람에게 물어본다. 사람이 블로그를 열어 보고 올라갔다 또는 안 올라갔다고 답하면 그걸로 기록을 정리한다.
브라우저를 띄워 자동으로 확인하는 방법도 목록에는 올렸지만 뒤로 미뤘다. 지금은 사람이 한 번 보는 게 제일 확실했다.
막는 것과 알려주는 것
장부가 생기니 중복 판단을 어디까지 프로그램에 맡길지 정해야 했다.
글은 소재와 유형의 조합으로 구분했다. 같은 소재라도 출시 소식으로 쓴 글과 비교로 쓴 글은 다른 글이다. 따로 번호를 발급하지 않고 이 조합을 그대로 이름표로 쓰니, 글을 만드는 쪽이 번호를 관리할 부담이 없었다.
같은 소재, 같은 유형, 같은 사이트에 완료 기록이 있으면 발행 도구가 막는다. 이건 판단이 아니라 사실이라서다. 여러 사이트에 동시에 올릴 때는 사이트마다 따로 기록한다.
그런데 “비슷한 글인가”는 도구가 판단하지 않게 했다. 소재가 달라도 내용이 겹칠 수 있고, 같은 소재라도 각도가 다르면 괜찮을 수 있다. 이런 판단을 규칙으로 짜기 시작하면 끝이 없다. 그래서 도구는 이 소재로 어느 사이트에 무슨 유형이 올라갔는지, 사이트별로 어떤 제목이 있는지 정보만 준다. 보고 판단하는 건 AI다. 그 조회를 가볍게 만든 얘기는 4편에 적었다.
테스트 초안이 장부를 더럽혔다
만들고 이틀 만에 장부가 지저분해졌다.
발행 기능을 고칠 때마다 초안으로 올려서 확인하곤 했다. 네이버는 임시저장, 워드프레스는 초안 상태로 올린다. 그런데 이것도 전부 장부에 기록되고 있었다. 발행 현황을 열면 실제로 공개된 글 사이에 시험 삼아 올린 초안이 섞여 있었다.
더 곤란한 건 중복 차단이었다. 시험 삼아 초안으로 올린 소재를 나중에 진짜로 올리려 하면 이미 기록이 있어서 걸릴 수 있다.
해결은 단순했다. 발행 상태가 초안이면 장부를 아예 건드리지 않는다. 올리는 중 기록도, 완료 기록도, 중복 확인도 전부 건너뛴다. 소재와 유형을 넘겼더라도 초안이면 추적하지 않는다. 같은 실수가 돌아오지 않게 테스트도 두 개 붙였다.
지웠는데 껍데기가 남았다
그 전날에는 반대 방향의 문제를 만났다.
장부는 두 층으로 되어 있다. 글 자체의 정보를 적는 곳과, 그 글을 어느 사이트에 어떤 상태로 올렸는지 적는 곳이다.
네이버에서 올리는 중으로 남은 기록을 확인해 보니 안 올라가 있었다. 그래서 안 올라갔다고 정리했는데, 이때 발행 기록만 지워지고 글 정보는 그대로 남았다. 어느 사이트에도 올라가 있지 않은 글이 발행 현황 화면과 색인에 유령처럼 떠 있었다.
어디에도 없는 글은 색인에 있을 이유가 없다. 그래서 발행 기록을 지울 때 그 글의 기록이 하나도 안 남으면 글 정보도 같이 지우게 했다. 다른 사이트에 올린 기록이 남아 있으면 글은 둔다. 목록을 보여줄 때도 기록 없는 글은 거르게 했고, 이미 쌓인 껍데기는 한 번에 청소했다. 장부 기록만 정리한 거라 실제 사이트의 글에는 영향이 없었다.
올린 본문도 장부에 넣었다
한참 뒤에 하나를 더 붙였다. 발행한 본문을 장부에 같이 보관하는 것이다.
그 전까지는 발행할 때마다 본문을 파일로 따로 저장했다. 폴더에 파일이 계속 늘었고, 무엇보다 파일을 쓰는 것 자체가 AI의 출력이라 비용이었다.
생각해 보니 본문은 발행 도구가 이미 받고 있었다. 올리려면 받아야 하니까. 그래서 발행이 성공하면 받은 본문을 그대로 장부에 저장하게 했다. 추가로 드는 토큰이 없다. 초안은 여기서도 빠진다.
본문은 글 정보 옆에 붙이지 않고 따로 뒀다. 같은 글이라도 사이트마다 본문이 다를 수 있어서 사이트 단위로 저장해야 했고, 중복 조회가 글 정보를 자주 훑는데 거기에 긴 본문이 얹히면 조회가 무거워진다. 주소나 상태처럼 이미 장부에 있는 값은 다시 적지 않았다.
발행 현황 화면에서 글마다 본문을 열어볼 수 있게 했는데, 서식을 입히지 않고 원문 그대로 보여준다. 평소에는 안 보는 보험이라 그 정도면 충분했다. 특히 네이버는 여기 남은 게 유일한 백업이다.
정리하면
실패를 막는 것보다 실패했다는 사실을 남기는 게 먼저였다. 프로그램이 언제 죽을지는 못 막는다. 대신 올리기 전에 먼저 적어두면 어디서 멈췄는지는 안다. 그 기록이 있어야 확인하고 복구할 수 있다.
기록하는 대상을 고르는 것도 설계였다. 모든 발행을 적으면 장부가 정확해질 줄 알았는데 오히려 시험용 초안이 섞여 쓸모가 떨어졌다. 무엇을 적을지만큼 무엇을 안 적을지가 중요했다. 지울 때도 마찬가지로, 한쪽만 지우면 다른 쪽에 껍데기가 남는다.
그리고 사실과 판단을 나눴다. 같은 글이 같은 사이트에 올라갔는지는 사실이니 도구가 막는다. 비슷한지는 판단이니 도구는 정보만 주고 AI가 정한다. 이 경계를 흐리면 도구가 점점 커지고, 틀린 판단을 도구 안에 숨기게 된다.