애드센스가 ‘가치 낮은 콘텐츠’로 반려했다 — 원인을 좁혀간 기록
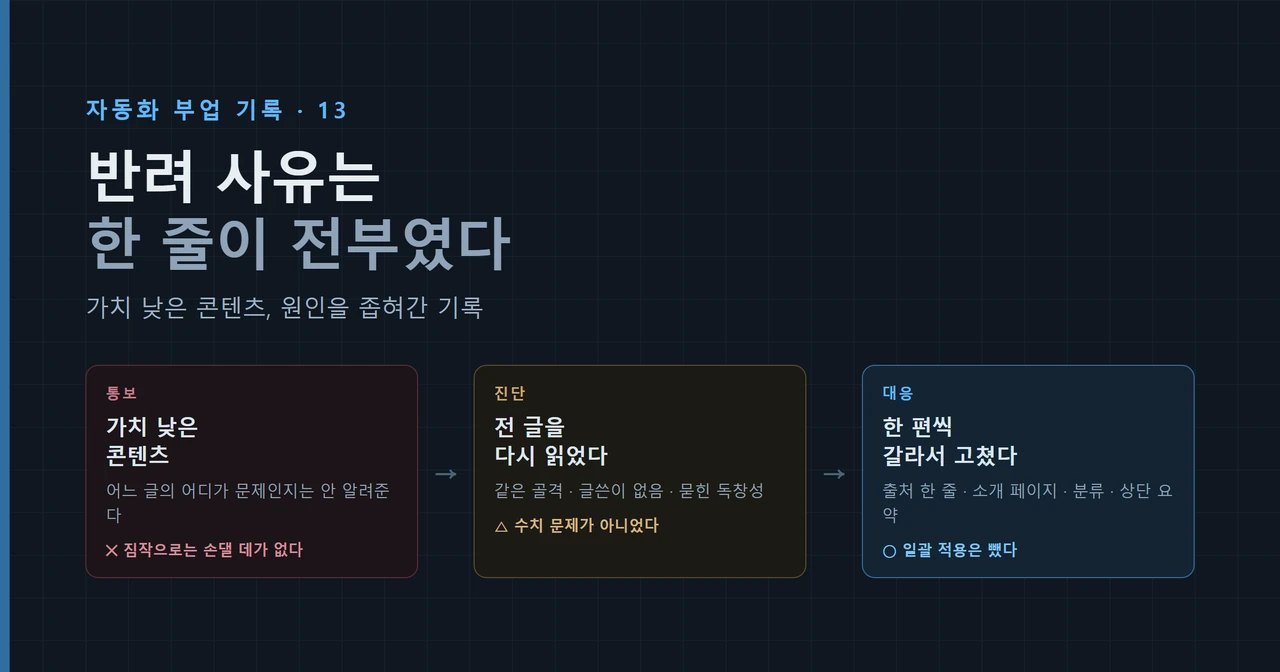
운영 중인 정보성 사이트 한 곳이 애드센스 심사에서 세 번째로 반려됐다. 사유는 “가치 낮은 콘텐츠” 한 줄이었다.
앞 글에서 다룬 색인 문제는 그래도 사정이 나았다. 어느 주소가 색인에 안 들어갔는지 목록으로 볼 수 있었다. 이번은 달랐다. 사유는 한 줄뿐이고 어느 글의 어느 부분이 문제인지는 알려주지 않는다.
글은 수십 편 쌓여 있었다. 소개 페이지와 문의 페이지, 개인정보 처리방침도 다 있었다. 편당 분량도 짧지 않았다. 그래서 처음에는 뭘 고쳐야 하는지 짐작이 안 갔다.
수치가 틀린 줄 알았다
제일 먼저 의심한 건 정확성이었다. 숫자가 틀린 글이 섞여 있어서 품질이 낮다고 판정된 것 아닐까 싶었다.
그래서 색인 대상 글 전부를 다시 읽고, 본문에 나오는 수치를 공식 자료와 대조했다. 쉰 편이 넘어서 며칠 걸렸다.
결과는 예상과 달랐다. 실제로 고쳐야 했던 계산 오류가 몇 건 나왔지만, 틀렸을 거라고 의심했던 수치는 대부분 맞았다. 여기서 알게 된 게 하나 있다. 부족한 건 정확성이 아니라 그 정확성을 보여줄 근거였다. 맞는 숫자를 써놓고도 어디서 가져왔는지 적어두지 않으면, 읽는 쪽에서는 지어낸 것과 구분할 방법이 없다.
그래서 전 글 하단에 자료 출처와 최종 확인일을 넣기로 했다. 글마다 참고한 기관과 확인한 날짜를 한 줄로 남기고, 그 날짜를 구조화 데이터의 수정일로도 연결했다.
요란하게 만들었다가 되돌렸다
여기서 삽질을 했다.
처음에 만든 건 각주가 아니라 박스였다. “이렇게 확인했습니다”라는 제목을 달고, 확인 절차를 몇 줄로 설명하고, 오류 제보 안내까지 넣은 블록이었다. 신뢰를 보여주려면 눈에 띄어야 한다고 생각했다.
전 글에 붙여놓고 보니 이상했다. 똑같은 문구가 담긴 똑같은 박스가 수십 편 하단에 반복되는 모양새였다. 고치려던 양산 인상을 오히려 키우고 있었다. 설명 문구도 과했다. 사람이 쓴 것처럼 보이려고 꾸민 문장은 꾸민 티가 그대로 난다.
그래서 두 번 줄였다. 박스를 담백한 각주로 바꾸고, 다시 자료 출처와 확인일만 남긴 한 줄로 축약했다. 주의 문구와 제보 안내는 이미 사이트 하단에 있으니 글마다 반복할 이유가 없었다.
신뢰는 선언해서 생기는 게 아니라 확인할 수 있는 흔적에서 생긴다. 그 흔적은 한 줄이면 됐다.
전 글이 같은 골격이었다
출처를 붙이고 나서 다시 봤는데도 뭔가 남아 있었다. 글을 나란히 놓고 목차만 뽑아보고 알았다.
전 글이 같은 골격이었다. 들어가며로 시작해서 자주 묻는 질문과 마무리로 끝나는 여덟 단계가 수십 편에 그대로 반복되고 있었다. 각 글의 내용은 달랐지만 구조는 한 틀에서 찍어낸 것처럼 같았다.
틀을 정해두고 쓴 건 효율 때문이었다. 매번 구성을 고민하지 않아도 되고, 빠뜨리는 항목도 없다. 그런데 그렇게 쌓인 결과물은 밖에서 보면 양산물로 보인다. 심사 쪽에서 글마다 내용을 읽어주길 기대할 수 없고, 똑같은 목차가 반복되는 것은 읽지 않아도 보인다.
글쓴이가 없었다
또 하나는 글쓴이였다.
그 사이트는 모든 글을 익명 “운영팀” 이름으로 내고 있었다. 신원을 드러내지 않는 게 안전하다고 봤고, 대신 검증 절차를 설명해서 신뢰를 세우려고 했다.
지금 보면 그건 성립하지 않았다. 복수형 익명 호칭은 아무것도 보증하지 않는다. 누가 썼는지도, 왜 이 사람 말을 믿어야 하는지도 없다.
실명을 쓰지 않기로 한 건 그대로 뒀다. 대신 소개 페이지를 고쳤다. 왜 이 사이트를 만들게 됐는지를 1인칭으로 적고, 하는 일과 하지 않는 일을 나눠 적었다. 상담이나 대행을 하지 않고, 중개 수수료를 받지 않고, 개인정보나 서류를 수집하지 않는다는 것을 명시했다. 광고로 운영하며 광고주가 내용 선정에 관여하지 않는다는 고지도 넣었다.
그리고 정보를 확인하는 순서를 네 단계로 공개했다. 출처를 찾고, 교차 확인하고, 기록하고, 갱신한다. 마지막 단계는 정정 이력 페이지로 연결했다. 그동안 어느 글의 무엇을 언제 고쳤는지 공개하는 페이지를 따로 만들었다. 항목은 전부 실제 커밋 기록에서 뽑았고, 문장을 다듬거나 링크를 정리한 것처럼 내용이 바뀌지 않은 수정은 기록하지 않는다고 적어뒀다. 기억으로 항목을 만들면 그 순간 이력이 아니게 된다.
호칭도 “운영팀”에서 “운영자”로 바꿨다.
분류가 아예 없었다
점검하다가 엉뚱한 걸 발견했다. 그 사이트에 카테고리 분류가 아예 없었다.
글이 예순 편을 넘겼는데 전부 한 목록에 평평하게 쌓여 있었다. 주제를 좁혀서 보려면 방법이 없었다. 분류를 일곱 개로 나누고 전 글에 붙였다. 상단 분류 바, 첫 화면의 주제별 찾기 그리드, 분류별 목록 페이지, 글 상단 이동 경로가 같은 정의 하나를 참조하게 했다.
여기서 안 한 것 두 가지를 적어둔다. 글이 0편인 분류는 페이지를 만들지 않게 막았다. 빈 목록 페이지는 심사에서 그 자체로 감점 항목이다. 태그별 목록 페이지도 만들지 않았다. 글당 태그가 여섯 일곱 개씩 붙어 있어서 페이지로 만들면 글 한두 개짜리 얇은 페이지가 백 개 넘게 생긴다. 분류를 만들면서 얇은 페이지를 백 개 찍어내는 건 앞뒤가 안 맞는다.
같은 점검에서 라이브 글이 아직 발행되지 않은 예약 글로 링크를 걸어 404가 나는 것도 찾았다. 세 건이었다. 손으로 고치려다 말았다. 간격을 두고 예약 발행하는 한 다음 글에서 또 생길 문제여서, 빌드할 때 미발행 글을 가리키는 링크는 문장만 남기고 링크를 떼도록 했다. 대상 글이 발행되는 날 빌드부터 링크가 저절로 돌아온다.
독창적인 부분이 아래에 묻혀 있었다
마지막은 순서 문제였다.
글마다 그 글에만 있는 내용이 있었다. 직접 계산해본 비교표, 다들 틀리는 지점, 조건이 갈리는 기준 같은 것들이다. 그런데 그게 전부 본문 중반 이후에 있었다. 첫 화면에는 어디서나 볼 수 있는 일반적인 설명이 깔려 있었다.
전 글 맨 위에 핵심 요약 박스를 넣으려고 했다. 그러다 멈췄다. 똑같은 박스를 수십 편에 붙이면 방금 고치려던 동일 골격 문제를 그대로 되풀이한다.
그래서 먼저 전 글을 다시 읽고 글마다 판정했다. 일흔 편 넘게 읽고 네 갈래로 나눴다. 끌어올릴 독창 포인트가 분명한 쪽, 첫 문단만 보강하면 되는 쪽, 글 자체가 부실해서 본문부터 고쳐야 하는 쪽, 그리고 이미 괜찮은 쪽이다.
읽어보니 서른 편 넘게는 이미 도입부가 구체적인 숫자나 함정으로 시작하고 있어 손대지 않았다. 열네 편은 도입부를 그 글의 독창 포인트로 교체하고, 스물세 편은 첫 문단 끝에 빠진 한 문단만 넣었다. 형태도 통일하지 않았다. 계산 대비형, 통념 반박형, 갈림길형으로 글 성격에 맞게 갈라 배정했다.
판별선이 하나 있었다. “들어가며”를 소제목으로 쓴 글은 예외 없이 손대야 하는 쪽이었다. 리드에서 한 말을 소제목으로 한 번 더 반복해 첫 화면을 채우는 구조라, 정작 그 글에만 있는 내용이 아래로 밀려 있었다. 그 글들에 한 작업은 박스를 더한 게 아니라 중복된 골격을 뺀 것이다.
읽는 김에 기존 버그도 하나 잡았다. 한 문단에 물결표가 두 개 들어가면 마크다운이 그 사이를 취소선으로 해석해서, 숫자 범위에 줄이 그어진 채로 라이브에 올라가 있었다. 스물세 편 마흔한 건이었다. 전 글 물결표를 이스케이프해서 막았다.
정리하면
“가치 낮은 콘텐츠”는 글이 짧다는 뜻이 아니었다.
모자란 건 눈에 보이는 양이 아니었다. 좁혀보니 세 갈래였다. 전 글이 같은 틀로 찍혀 나온다는 인상, 누가 썼는지 알 수 없다는 점, 그 글에만 있는 내용이 아래에 묻혀 있다는 점.
고치는 과정에서 두 번 틀렸다. 한 번은 신뢰를 요란하게 보여주려다 똑같은 박스를 수십 편에 붙여 양산 인상을 키운 것이고, 한 번은 전 글에 요약을 일괄 적용하려 한 것이다. 둘 다 같은 실수였다. 전 글에 똑같은 걸 붙이는 방식으로는 전 글이 똑같다는 문제를 못 고친다. 일괄 적용은 쌓을 때나 빠른 방법이고, 쌓인 걸 고칠 때는 한 편씩 읽는 수밖에 없었다.
지금은 고쳐두고 결과를 기다리는 중이다. 이번에 고친 것들이 사유를 제대로 짚었는지는 아직 모른다. 다만 반려 사유 한 줄을 받아들고 할 수 있는 건, 짐작으로 아무 데나 손대는 게 아니라 글을 전부 다시 읽어 원인을 좁히는 일뿐이었다.